
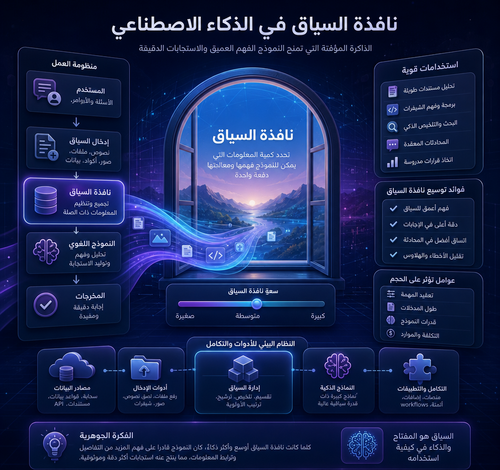
نافذة السياق في الذكاء الاصطناعي: دليلك الشامل لفهمها واستخدامها بذكاء
مقدمة: لماذا يجب أن تفهم نافذة السياق قبل أي شيء آخر؟
هل سبق أن لاحظت أن نموذج الذكاء الاصطناعي الذي تستخدمه “نسي” ما قلته في بداية المحادثة؟ أو أنه بدأ يعطيك إجابات غير متسقة بعد نقاش طويل؟ هذا ليس خللاً عشوائياً، بل هو نتيجة مباشرة لمفهوم نافذة السياق. هذا المفهوم هو أحد أكثر العناصر تأثيراً في جودة تجربتك مع أدوات الذكاء الاصطناعي، سواء كنت مطوراً، كاتباً، باحثاً، أو مجرد مستخدم يومي يريد الاستفادة القصوى من هذه الأدوات. فهم Context Window ليس ترفاً تقنياً، بل هو المفتاح الحقيقي للتحكم في نتائج نماذج اللغة الكبيرة.
ما الذي تحتاج معرفته أولاً؟
دعني أشرح لك الفكرة بشكل مبسط دون تعقيد غير ضروري.
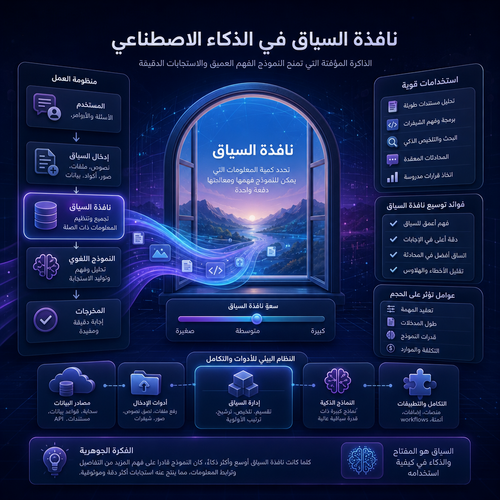
نماذج الذكاء الاصطناعي اللغوية مثل GPT-4 أو Claude أو Gemini لا “تتذكر” المحادثات السابقة بالطريقة التي يتذكرها البشر. كل مرة تُرسل فيها رسالة، يقرأ النموذج الحوار بأكمله من الصفر، لكنه لا يستطيع قراءة ما هو أطول من حجم معين. هذا الحجم المحدود هو ما نسميه “نافذة السياق”.
بمعنى أوضح: تخيّل أن النموذج يعمل مثل شخص يقرأ ورقة محادثة، لكن هذه الورقة لها طول محدود. إذا امتدت المحادثة أكثر من هذا الطول، فإن ما كُتب في البداية يختفي تدريجياً من نطاق رؤيته.
وحدة القياس هنا هي التوكن (Token)، وليست الكلمات مباشرةً. التوكن الواحد يساوي تقريباً ثلاثة أرباع كلمة إنجليزية، أو أقل في حالة النصوص العربية التي تستهلك عادةً توكنات أكثر بسبب طبيعة بنيتها اللغوية.
النماذج المختلفة تمتلك نوافذ سياق مختلفة:
- GPT-3.5: حوالي 16,000 توكن
- GPT-4o: يصل إلى 128,000 توكن
- Claude 3.5: يصل إلى 200,000 توكن
- Gemini 1.5 Pro: يصل إلى مليون توكن
الأدوات والمتطلبات التي تحتاجها
قبل أن تبدأ في التعامل الاحترافي مع هذا المفهوم، إليك ما تحتاجه:
الأدوات الأساسية:
- حساب على ChatGPT (OpenAI): النسخة المدفوعة Plus أو Team للوصول لنماذج بنوافذ سياق أوسع
- حساب على Claude (Anthropic): مميز لأن نافذته من الأوسع في السوق حالياً
- Gemini Advanced من Google: خيار ممتاز للمشاريع الطويلة جداً
أدوات لقياس عدد التوكنات:
- OpenAI Tokenizer: أداة مجانية على موقع OpenAI تتيح لك عدّ التوكنات قبل الإرسال
- Tiktoken: مكتبة Python للمطورين الذين يعملون عبر API
- LangChain Token Counter: مفيد إذا كنت تبني تطبيقات باستخدام LangChain
للمطورين تحديداً:
- مفتاح API من المزود المناسب
- بيئة Python أو Node.js
- مكتبة LangChain أو LlamaIndex لإدارة السياق بشكل متقدم
للمستخدمين العاديين:
- لا تحتاج أكثر من متصفح وحساب على إحدى المنصات المذكورة
متى تحتاج الاهتمام بهذا الموضوع تحديداً؟
هذا المفهوم يصبح حرجاً في سيناريوهات محددة جداً، وليس في كل استخدام عادي. إليك الحالات التي يجب فيها أن تكون واعياً تماماً لحجم نافذة السياق:
عند تحليل مستندات طويلة: إذا كنت تريد من النموذج تلخيص عقد قانوني من 100 صفحة أو تقرير بحثي ضخم، فأنت بحاجة لنموذج بنافذة سياق كبيرة بما يكفي لاستيعابه.
عند بناء chatbots: إذا كنت مطوراً يبني روبوت محادثة، ستصطدم بهذا المحدد عندما تطول المحادثات.
في جلسات التطوير البرمجي: كتابة الكود لمشاريع كبيرة تستهلك الكثير من التوكنات، وقد ينسى النموذج الكود الذي كتبه في البداية.
للكتّاب والمحررين: تحرير روايات أو مقالات طويلة يتطلب نموذجاً يستطيع “رؤية” النص كاملاً.
في الأبحاث الأكاديمية: مراجعة أوراق بحثية متعددة في جلسة واحدة.
الشرح التفصيلي خطوة بخطوة: كيف تتعامل مع نافذة السياق باحترافية
الخطوة الأولى: اعرف حجم نافذة النموذج الذي تستخدمه
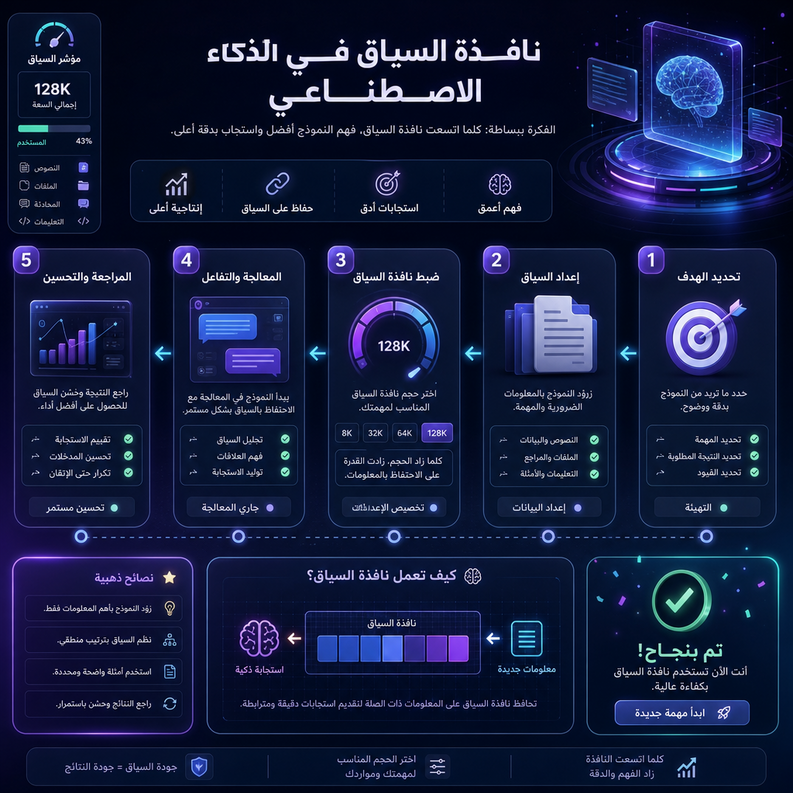
قبل أي شيء، اذهب إلى توثيق المزود الذي تتعامل معه وتحقق من الحد الأقصى للتوكنات. هذه المعلومة تحدد استراتيجيتك بالكامل. لا تفترض، تحقق.
تحذير مهم: بعض المنصات تعرض نافذة سياق كبيرة لكن الأداء يتراجع بشكل ملحوظ مع الاقتراب من الحد الأقصى. هذه ظاهرة معروفة تُسمى “Lost in the Middle”.
الخطوة الثانية: تعلم كيف تحسب التوكنات
اذهب إلى أداة Tokenizer من OpenAI، انسخ نصك والصقه، وستعرف فوراً كم توكناً يستهلك. كقاعدة عامة:
- صفحة نصية إنجليزية واحدة = 500-700 توكن تقريباً
- الصفحة العربية = 700-1000 توكن بسبب تعقيد الحروف
الخطوة الثالثة: قسّم المهام الكبيرة
بدلاً من رمي 50,000 كلمة دفعة واحدة، قسّم مهمتك إلى أجزاء منطقية. على سبيل المثال:
- لخّص كل فصل من الكتاب بشكل منفصل
- ثم اطلب من النموذج دمج هذه الملخصات
- ثم اطلب التلخيص النهائي
هذا النهج يُسمى Map-Reduce في عالم المطورين وهو فعّال جداً.
الخطوة الرابعة: ضع أهم المعلومات في البداية دائماً
الأبحاث أثبتت أن نماذج اللغة تنتبه أكثر لما في بداية ونهاية النافذة، وتُقلل انتباهها لما في الوسط. لذلك، ضع التعليمات الأساسية والمعلومات الحرجة في بداية رسالتك، ثم أعد ذكر النقاط المهمة في النهاية.
الخطوة الخامسة: استخدم ذاكرة خارجية عند الحاجة
هنا يدخل مفهوم نافذة السياق في منطقة أكثر تقدماً. عندما تتجاوز احتياجاتك حدود النافذة، يمكنك:
- استخدام RAG (Retrieval-Augmented Generation): يخزن المعلومات في قاعدة بيانات ويسترجع ما يلزم فقط
- استخدام ذاكرة ChatGPT الدائمة (Memory Feature)
- استخدام أدوات مثل LlamaIndex لإدارة السياق ديناميكياً
الخطوة السادسة: جرب النموذج المناسب للمهمة
ليس كل مهمة تحتاج نافذة سياق ضخمة. استخدم النموذج المناسب لكل مهمة وفر تكلفتك إذا كنت تدفع بالاستخدام. فهم Context Window يساعدك في اتخاذ قرارات اقتصادية أفضل.
الفوائد الحقيقية من فهم هذا المفهوم
عندما تفهم هذا المفهوم جيداً، تحدث تحولات ملموسة في طريقة عملك:
- توفير المال: إذا كنت تستخدم API بالدفع لكل توكن، فتحسين استخدامك يقلل فاتورتك بشكل مباشر
- نتائج أدق: تصميم المحادثات بذكاء يضمن أن النموذج دائماً “يرى” المعلومات الصحيحة
- تجنب الأخطاء المحرجة: لن يعطيك النموذج معلومات متناقضة لأنه “نسي” ما قاله سابقاً
- إنتاجية أعلى: تقضي وقتاً أقل في إعادة شرح السياق
نصائح متقدمة وبدائل ذكية
للمستخدمين العاديين:
- احتفظ بـ”system prompt” موجز يحتوي على أهم المعلومات الثابتة
- لا تبدأ محادثات جديدة لمجرد التجديد؛ استمر في المحادثة نفسها مع إدارتها جيداً
للمطورين:
- استخدم Sliding Window عند بناء chatbots: احتفظ فقط بآخر N رسائل
- جرب Summarization Buffer Memory في LangChain: يلخص المحادثة القديمة تلقائياً
- استكشف Pinecone أو Weaviate لتخزين المعلومات خارج النافذة واسترجاعها عند الحاجة
الأخطاء الشائعة التي يجع تجنبها
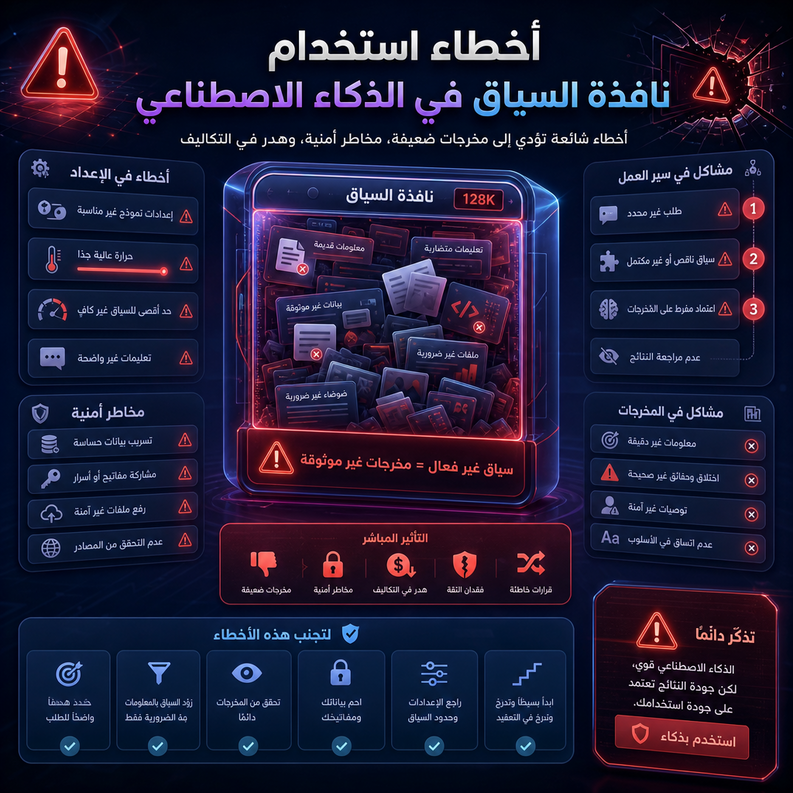
الخطأ الأول: افتراض أن النموذج يتذكر كل شيء دائماً الحل: تحقق من طول محادثتك بانتظام، وأعد تقديم المعلومات الحرجة عند الحاجة.
الخطأ الثاني: وضع أهم التعليمات في منتصف نص طويل جداً الحل: ضعها في البداية دائماً، أو كررها في النهاية.
الخطأ الثالث: استخدام نموذج بنافذة صغيرة لمهمة تحتاج نافذة كبيرة الحل: اقرأ توثيق النموذج قبل اختياره للمهمة.
الخطأ الرابع: إهدار التوكنات في تعليمات مكررة أو غير ضرورية الحل: اجعل تعليماتك موجزة ودقيقة، واحذف أي تكرار.
الخطأ الخامس: عدم اختبار سلوك النموذج عند الاقتراب من الحد الأقصى الحل: دائماً اختبر سيناريوهات القدرة القصوى في بيئة تجريبية قبل الإنتاج الفعلي.
كيف تتحسن على المدى البعيد في هذا المجال؟
هذا الميدان يتطور بسرعة مذهلة. ما يصح اليوم قد يتغير بعد ستة أشهر. إليك ما أنصح به لتبقى في المقدمة:
- تابع توثيق المزودين بانتظام: OpenAI وAnthropic وGoogle يُحدّثون نماذجهم باستمرار
- اشترك في النشرات التقنية المتخصصة: مثل The Batch من DeepLearning.AI
- جرب نماذج مفتوحة المصدر: مثل Llama من Meta لفهم كيف تعمل الأمور من الداخل
- ابنِ مشاريع صغيرة: لا شيء يُثبّت المعرفة مثل تطبيقها في مشروع حقيقي ولو بسيط
- شارك في مجتمعات مثل Hugging Face وReddit r/LocalLLaMA
الخلاصة: فهم نافذة السياق هو بداية الاستخدام الحقيقي
إذا كنت تستخدم أدوات الذكاء الاصطناعي دون أن تفهم نافذة السياق، فأنت تقود سيارة دون أن تفهم كيف تعمل المحرك. لن تتوقف بالضرورة، لكنك لن تستخرج منها أقصى إمكاناتها. ما ناقشناه في هذا المقال ليس معلومات نظرية، بل هو أساس عملي يغير طريقة تفاعلك مع هذه الأدوات يومياً.
سواء كنت تكتب محتوى، تطور تطبيقات، تحلل بيانات، أو تبحث عن معلومات، فإن التعامل الذكي مع Context Window سيجعل نتائجك أدق، عملك أسرع، وتجربتك أقل إحباطاً. ابدأ بتطبيق ما تعلمته اليوم، وستلاحظ الفرق من المحادثة الأولى.
الأسئلة الشائعة
س1: هل نافذة السياق الأكبر تعني دائماً نموذجاً أفضل؟ ليس بالضرورة. النافذة الكبيرة مفيدة في مهام بعينها، لكن جودة النموذج تعتمد على عوامل كثيرة منها: التدريب، والدقة، والتخصص. نموذج بنافذة 32K متدرب جيداً قد يتفوق على نموذج بنافذة 200K في مهام التلخيص العامة.
س2: كيف أعرف أن محادثتي اقتربت من حد نافذة السياق؟ أوضح علامة هي أن النموذج يبدأ “بنسيان” معلومات ذكرتها في بداية المحادثة أو يتناقض مع ما قاله سابقاً. يمكنك أيضاً استخدام أدوات عد التوكنات المذكورة في المقال لمراقبة الوضع بدقة.
س3: هل يمكنني توسيع نافذة السياق بأي طريقة؟ لا يمكنك توسيعها تقنياً في النموذج نفسه، لكن يمكنك محاكاة سياق أوسع باستخدام تقنيات مثل RAG أو Summarization Buffer. هذه الحلول لا توسع النافذة، بل تديرها بذكاء.
س4: هل النصوص العربية تستهلك توكنات أكثر من الإنجليزية؟ نعم، بشكل عام. معظم نماذج اللغة تدرّبت على كميات أكبر من النصوص الإنجليزية، مما يجعل encoding النص العربي أقل كفاءة ويستهلك توكنات أكثر لنفس الكمية من المعلومات. هذا عامل مهم يجب أخذه في الحسبان عند تقدير التكاليف.
س5: هل ذاكرة ChatGPT الدائمة (Memory) تحل مشكلة نافذة السياق؟ جزئياً فقط. الذاكرة الدائمة تخزن معلومات ملخصة عن المستخدم بين الجلسات المختلفة، لكنها لا تحل مشكلة المحادثات الطويلة داخل الجلسة الواحدة. هي إضافة مفيدة لكنها ليست بديلاً كاملاً.



