RAG للمبتدئين: كيف تبني نظام استرجاع ذكي للمعلومات خطوة بخطوة
مقدمة: لماذا أصبح RAG ضرورة وليس رفاهية؟
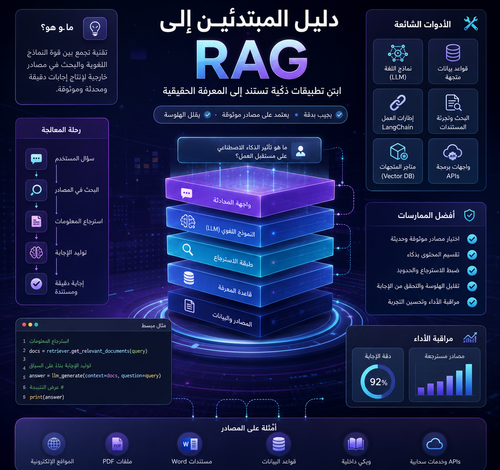
صراحةً، أول مرة سمعت فيها عن مفهوم RAG للمبتدئين ظننت أنه مجرد مصطلح تقني آخر سيُنسى بعد أشهر. لكن بعد أن بدأت أطبّقه فعلياً في مشاريعي، اكتشفت أنه يحل مشكلة حقيقية كنت أعاني منها يومياً وهي كيف تجعل نموذج الذكاء الاصطناعي يجيب بناءً على بياناتك الخاصة لا على معلومات عامة قد تكون منتهية الصلاحية. تقنية RAG أو Retrieval-Augmented Generation هي الجسر الذي يربط بين قواعد البيانات الخاصة بك وبين نماذج اللغة الكبيرة، وهي اليوم تُستخدم من قِبل الشركات الكبرى والمطورين المستقلين على حدٍّ سواء. وعندما نتحدث عن البحث داخل الوثائق، فنحن نتحدث عن اللبنة الأساسية في بناء أي تطبيق ذكاء اصطناعي يعمل بمعلومات دقيقة وموثوقة.
ما الذي تحتاج معرفته أولاً؟
قبل أن نبدأ، دعني أوضح لك المفهوم بشكل بسيط دون مصطلحات معقدة.
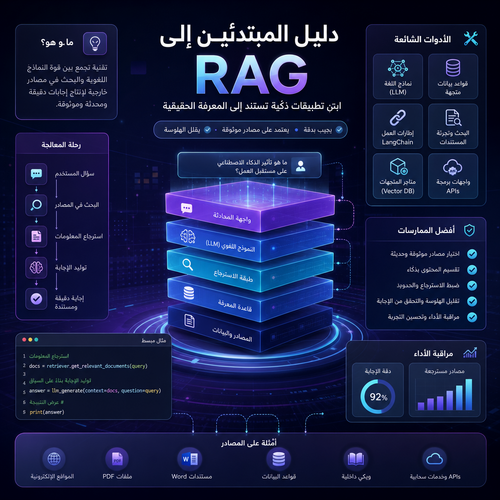
RAG هو اختصار لـ Retrieval-Augmented Generation، ويعني باختصار: بدلاً من أن تسأل نموذج الذكاء الاصطناعي سؤالاً وتنتظر إجابة مبنية على تدريبه العام، تمنحه الوصول إلى مصادر محددة تختارها أنت، سواء كانت ملفات PDF، أو قواعد بيانات، أو صفحات ويب، أو وثائق داخلية. النموذج يبحث في هذه المصادر أولاً ثم يصيغ إجابة مستندة إليها مباشرة.
الفرق الجوهري بين RAG والنماذج التقليدية هو:
- النموذج التقليدي: يجيب بناءً على ما تعلّمه أثناء التدريب فقط.
- نموذج RAG: يجيب بناءً على ما تعلّمه + ما تُخبره به في الوقت الفعلي من مستنداتك.
هذا يجعل RAG مثالياً للشركات التي تريد نظام دعم عملاء يعرف سياساتها الداخلية، أو للباحثين الذين يريدون تحليل مئات الأوراق العلمية، أو لأي شخص يريد بناء “مساعد ذكي” يعرف محتوى موقعه أو منتجاته تماماً.
الأدوات والمتطلبات التي ستحتاجها
من تجربتي العملية، إليك القائمة الكاملة لما تحتاجه قبل أن تبدأ:
الأدوات الأساسية:
- Python 3.10+ — لغة البرمجة التي سنعمل بها
- LangChain أو LlamaIndex — أُطر عمل مخصصة لبناء تطبيقات RAG بسهولة
- OpenAI API أو Ollama — النموذج اللغوي الذي سيولّد الإجابات (Ollama للعمل المحلي المجاني)
- ChromaDB أو FAISS — قاعدة بيانات متجهية لحفظ واسترجاع الوثائق
- مكتبة PyPDF2 أو pdfplumber — لاستخراج النصوص من ملفات PDF
الحسابات المطلوبة:
- حساب على [platform.openai.com](https://platform.openai.com) إذا أردت استخدام GPT
- حساب على Hugging Face كبديل مجاني للنماذج
بيئة العمل:
- يُنصح باستخدام VS Code أو Jupyter Notebook
- تثبيت pip وvirtualenv لإدارة المكتبات
بدائل مبسطة للمبتدئين:
إذا كانت البرمجة ليست مجالك، يمكنك استخدام منصات جاهزة مثل Flowise أو Dify.ai التي تتيح بناء أنظمة RAG بواجهة بصرية دون كتابة كود.
متى تحتاج فعلاً لاستخدام RAG؟
الحقيقة أن RAG ليس الحل المناسب لكل موقف. بعد التجربة والخطأ، توصلت إلى أن هذه التقنية تتألق في الحالات التالية:
عندما تكون بياناتك متغيرة باستمرار: مثل قواعد بيانات المنتجات، أو أسعار السوق، أو مستودعات التوثيق التقني. لا يمكنك إعادة تدريب نموذج كل أسبوع، لكن يمكنك تحديث وثائق RAG في دقائق.
عندما تحتاج دقة عالية وإجابات موثوقة: في القطاعات القانونية والطبية والمالية، لا مجال للتخمين. RAG يجبر النموذج على الاستناد لمصدر محدد يمكنك التحقق منه.
عندما تعمل على مشاريع المؤسسات: بناء روبوت محادثة داخلي يعرف سياسات HR، أو نظام يجيب على أسئلة العملاء بناءً على دليل المنتج — هذا بالضبط ما يُبدع فيه RAG.
في التعليم والبحث العلمي: تحميل مئات الأبحاث والمراجع ثم سؤال النموذج عن مفاهيم محددة أو مقارنة آراء الباحثين — توفير هائل في الوقت.
في إدارة المحتوى الرقمي: إذا كنت تدير مدونة أو موقع محتوى وتريد مساعداً ذكياً يعرف جميع مقالاتك ويرشد الزوار.
دليل خطوة بخطوة: بناء نظام RAG من الصفر
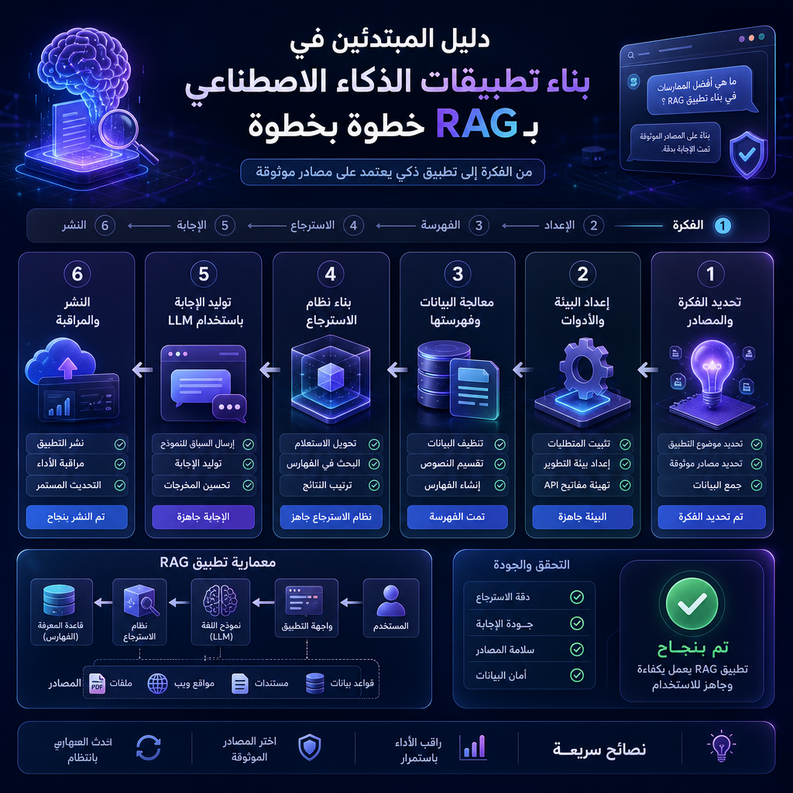
سأأخذك عبر مسار عملي مباشر. هذا المشروع سينتهي بك ببناء نظام يقرأ ملف PDF ويجيب على أسئلتك عنه. مفهوم RAG للمبتدئين يبدأ من هنا فعلياً.
الخطوة الأولى: إعداد البيئة
“bash pip install langchain openai chromadb pypdf tiktoken “
أنشئ مجلداً جديداً للمشروع وافتحه في VS Code.
الخطوة الثانية: تحميل الوثائق وتقسيمها
“`python from langchain.document_loaders import PyPDFLoader from langchain.text_splitter import RecursiveCharacterTextSplitter
loader = PyPDFLoader(“your_document.pdf”) documents = loader.load()
splitter = RecursiveCharacterTextSplitter( chunk_size=500, chunk_overlap=50 ) chunks = splitter.split_documents(documents) “`
تنبيه مهم: حجم chunk_size مؤثر جداً. إذا كان صغيراً جداً فستفقد السياق، وإذا كان كبيراً جداً ستزيد التكاليف وتقل الدقة. 500 إلى 1000 حرف هو الأنسب للبداية.
الخطوة الثالثة: تحويل النصوص إلى متجهات وحفظها
“`python from langchain.embeddings import OpenAIEmbeddings from langchain.vectorstores import Chroma
embeddings = OpenAIEmbeddings() vectorstore = Chroma.from_documents(chunks, embeddings) “`
هذه الخطوة هي القلب النابض في النظام. كل قطعة نصية تتحول إلى “بصمة رقمية” تمكّن النظام من إيجاد أقرب النصوص لأي سؤال.
الخطوة الرابعة: إنشاء سلسلة الاسترجاع
“`python from langchain.chains import RetrievalQA from langchain.llms import OpenAI
llm = OpenAI(temperature=0) qa_chain = RetrievalQA.from_chain_type( llm=llm, retriever=vectorstore.as_retriever(search_kwargs={“k”: 3}) ) “`
المعامل k=3 يعني أن النظام سيسترجع أفضل 3 مقاطع ذات صلة قبل توليد الإجابة.
الخطوة الخامسة: اختبار النظام
“python query = "ما هي النقاط الرئيسية في هذا المستند؟" result = qa_chain.run(query) print(result) “
والآن نصل للجزء الأكثر تقدماً. عندما نتحدث عن البحث داخل الوثائق، يجب أن تعلم أن جودة الاسترجاع تعتمد على جودة نموذج الـ Embedding الذي تستخدمه. نموذج text-embedding-3-small من OpenAI هو الأفضل تكلفةً وأداءً للمشاريع المتوسطة الحجم.
فوائد RAG وأهميته الحقيقية
بعد أن بنيت عدة أنظمة RAG، هذه هي الفوائد التي لمستها فعلياً:
دقة لا تُضاهى: النموذج لا يخترع إجابات بل يستند لمصدر يمكنك الرجوع إليه والتحقق منه يدوياً.
تكلفة أقل من إعادة التدريب: Fine-tuning نموذج يكلف آلاف الدولارات وأسابيع من العمل. RAG يكلف سنتات لكل استعلام.
تحديثات فورية: أضف وثيقة جديدة، والنظام يعرفها فوراً دون أي إعادة تدريب.
شفافية المصدر: يمكنك برمجة النظام ليذكر من أي صفحة وأي وثيقة جاءت الإجابة، وهذا أمر حيوي في البيئات المهنية.
قابلية التوسع: يمكن توسيع قاعدة الوثائق من عشرات إلى ملايين المستندات دون تغيير في بنية النظام.
نصائح إضافية وأفضل الممارسات
من الأشياء التي تعلمتها بالتجربة ولم أجدها في معظم المقالات:
استخدم Hybrid Search: الجمع بين البحث المتجهي (Semantic Search) والبحث الكلاسيكي بالكلمات المفتاحية يعطي نتائج أفضل بكثير، خاصة للمحتوى التقني الذي يحتوي مصطلحات محددة.
أضف Metadata لوثائقك: عنوان الوثيقة، تاريخها، مصدرها، هذه البيانات الوصفية تساعد النظام على تصفية النتائج وترتيب الأولويات.
استخدم Re-ranking: بعد استرجاع أفضل 10 مقاطع، استخدم نموذج ترتيب ثانوي مثل Cohere Rerank لاختيار أفضل 3 منها. يحسن الدقة بشكل ملحوظ.
اختبر بأسئلة متنوعة: لا تقتصر على اختبار ما يعمل. اختبر الحالات الحدية، الأسئلة الغامضة، والأسئلة خارج نطاق وثائقك لتعرف كيف يتصرف النظام.
بديل مجاني للمبتدئين: استخدم Ollama مع نموذج Mistral 7B محلياً مع ChromaDB — نظام RAG كامل يعمل على حاسوبك دون أي تكلفة.
الأخطاء الشائعة التي يقع فيها المبتدئون
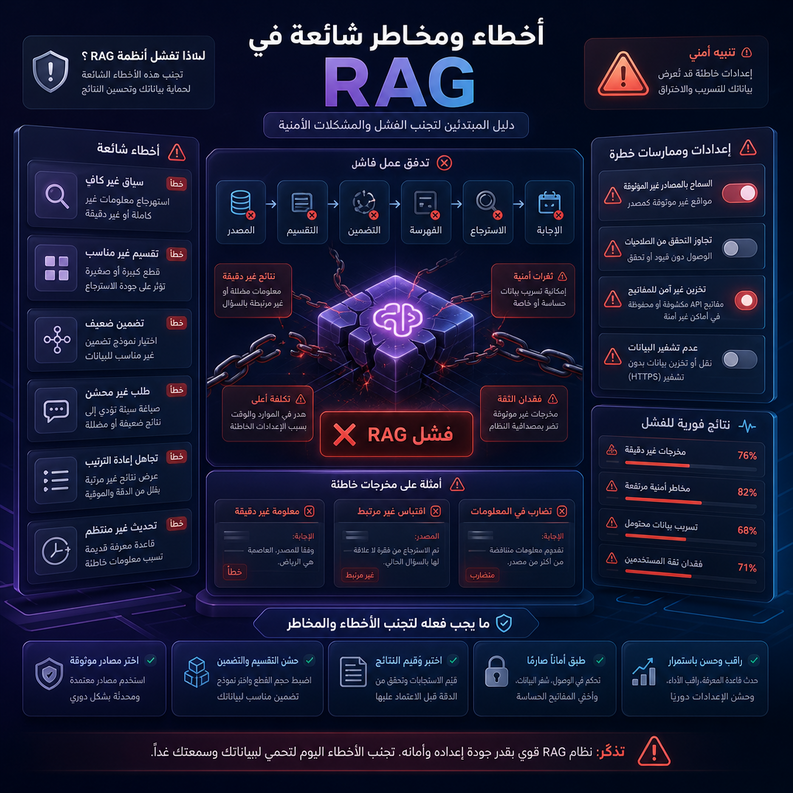
الخطأ الأول: تجاهل جودة الوثائق المُدخلة PDF ممسوح ضوئياً (Scanned PDF) لن يعطي نصاً قابلاً للاستخدام. تأكد أن وثائقك نصية وقابلة للنسخ قبل أي شيء.
الخطأ الثاني: chunk_size خاطئ تقسيم النصوص بشكل عشوائي بدون مراعاة البنية المنطقية للمحتوى يكسر السياق ويعطي إجابات منقوصة.
الخطأ الثالث: عدم تقييم النظام بشكل منهجي لا تعتمد على انطباعاتك الشخصية. استخدم أُطر تقييم مثل RAGAs لقياس دقة الاسترجاع وجودة الإجابات رقمياً.
الخطأ الرابع: حفظ المفاتيح السرية في الكود مباشرة API Keys يجب أن تكون في ملف .env منفصل وليس في الكود مباشرة. هذا خطأ أمني فادح.
الخطأ الخامس: إهمال معالجة حالة “لا توجد إجابة” يجب أن يعرف نظامك متى يقول “لا أملك معلومات كافية” بدلاً من اختراع إجابة. ضع تعليمات واضحة في الـ Prompt تمنع التخمين.
كيف تحسّن نظامك على المدى البعيد؟
بناء نظام RAG هو نقطة البداية، لكن التحسين المستمر هو ما يصنع الفارق:
سجّل الأسئلة والإجابات: احتفظ بسجل كامل لكل ما يسأله المستخدمون. هذه البيانات ذهب خالص لتحسين النظام ومعرفة ثغرات قاعدة وثائقك.
حدّث وثائقك بانتظام: ضع جدولاً زمنياً لمراجعة وتحديث المصادر التي يستند إليها النظام، خاصة في المجالات سريعة التغير.
أضف طبقة تحقق بشري: للقرارات الحساسة، لا تعتمد على النظام وحده. اجعل مراجعة بشرية جزءاً من سير العمل.
استكشف الجيل القادم: تقنيات مثل Agentic RAG وGraphRAG تأخذ قدرات الاسترجاع لمستوى أعلى بكثير وتستحق متابعتك.
بنِ مجتمع اختبار: اطلب من زملائك أو المستخدمين الأوائل اختبار النظام بأسئلة حقيقية وتزويدك بتغذية راجعة صريحة.
الخلاصة
إذا وصلت لهذه النقطة فأنت الآن تفهم بعمق ما يعنيه مصطلح RAG للمبتدئين وكيف يمكنك تطبيقه من الصفر. الفكرة ليست معقدة كما تبدو، والأدوات المتاحة اليوم تجعل البناء أسرع مما كان عليه قبل عام واحد فقط. ما أنصحك به الآن هو أن تأخذ مستنداً واحداً تملكه، سياسة عمل، كتيب منتج، مقالة بحثية، وتطبّق الخطوات التي شرحناها اليوم عليه. ستفاجأ كم هو سهل وكم هو مفيد. وتذكر أن البحث داخل الوثائق هو الأساس الذي يقوم عليه كل شيء، لذا لا تُهمل جودة مصادرك ودقة عملية الاسترجاع. ابدأ صغيراً، قيّم باستمرار، وسع تدريجياً.
الأسئلة الشائعة
س: هل أحتاج خبرة في البرمجة لبناء نظام RAG؟ ج: خبرة أساسية في Python تكفي للبدء. ولو لا تريد برمجة، منصات مثل Flowise وDify.ai تتيح بناء الأنظمة بالسحب والإفلات.
س: ما الفرق بين RAG وFine-tuning؟ ج: Fine-tuning يعدّل النموذج نفسه ويكلف كثيراً. RAG يضيف معرفة خارجية دون تعديل النموذج وهو أسرع وأرخص وأسهل في التحديث.
س: هل يمكن استخدام RAG مع لغات غير الإنجليزية؟ ج: نعم تماماً. نماذج الـ Embedding الحديثة تدعم العربية وعشرات اللغات الأخرى بكفاءة عالية.
س: ما حجم الملفات التي يمكن لـ RAG معالجتها؟ ج: نظرياً لا حد. يمكنك معالجة ملايين الوثائق طالما قاعدة البيانات المتجهية مصممة للتوسع. ChromaDB تناسب المشاريع الصغيرة، بينما Pinecone وWeaviate تناسب المشاريع الكبيرة.
س: كيف أضمن أن النظام لا يخترع معلومات غير موجودة في وثائقي؟ ج: اكتب Prompt واضحاً يأمر النموذج بعدم الإجابة إذا لم يجد معلومات في السياق المقدم. أيضاً، استخدام درجة حرارة (temperature) منخفضة مثل 0 أو 0.1 يقلل التخمين بشكل كبير.