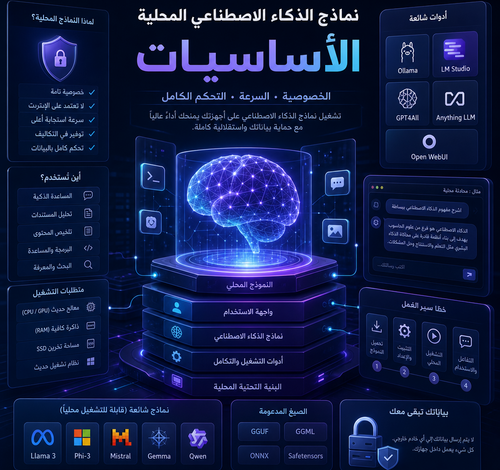
كيف تشغّل نماذج AI على جهازك دون الحاجة إلى إنترنت
مقدمة: الذكاء الاصطناعي في يدك — بدون اتصال وبدون رقابة
هل فكّرت يومًا أن تستخدم الذكاء الاصطناعي دون أن ترسل بياناتك إلى خوادم خارجية؟ هذا بالضبط ما يتيحه تشغيل نماذج AI محلية مباشرةً على جهازك الشخصي. في عالم أصبح فيه الخصوصية الرقمية هاجسًا حقيقيًا، وتكاليف الاشتراك في خدمات الذكاء الاصطناعي تتصاعد باستمرار، يبدو هذا الخيار أكثر منطقية من أي وقت مضى. أنا شخصيًا جرّبت هذا النهج منذ أكثر من عام، وكان من أفضل القرارات التقنية التي اتخذتها، خاصةً لمن يعملون في مجالات حساسة أو يريدون التحكم الكامل في أدواتهم.
ما أهمية تشغيل نماذج الذكاء الاصطناعي محليًا؟
في السنوات الأخيرة، انتشرت خدمات الذكاء الاصطناعي كالفطر بعد المطر — ChatGPT، Claude، Gemini، وغيرها. كلها رائعة، لكنها تشترك في مشكلة واحدة: بياناتك تذهب إلى مكان ما لا تعرفه تمامًا.
هنا يأتي دور نماذج AI محلية، وهي نماذج ذكاء اصطناعي تعمل بالكامل على معالج جهازك دون إرسال أي شيء عبر الإنترنت. الفائدة مزدوجة: أولًا الخصوصية التامة، وثانيًا القدرة على العمل حتى في غياب الاتصال بالشبكة.
Local AI ليس مجرد مصطلح تقني بارد، بل هو مفهوم عملي يغير طريقة تعاملك مع أدوات الذكاء الاصطناعي يوميًا. سواء كنت مطورًا، كاتب محتوى، باحثًا، أو مجرد شخص يقدّر خصوصيته الرقمية، هذا الموضوع يخصك مباشرة.
ما الذي تحتاج أن تعرفه قبل البدء؟
قبل أن نبدأ في الخطوات العملية، دعني أوضح لك المفهوم الأساسي حتى لا تشعر بالضياع.
نماذج اللغة الكبيرة — مثل LLaMA من Meta، أو Mistral، أو Phi من Microsoft — هي في الأصل نماذج مفتوحة المصدر يمكن تحميلها وتشغيلها على أجهزة شخصية. الفرق بينها وبين ChatGPT مثلًا هو أن ChatGPT يعمل على خوادم OpenAI البعيدة، بينما هذه النماذج تعمل على معالج جهازك مباشرة.
الأداة الأكثر شيوعًا لتحقيق هذا هي Ollama — وهي أداة مفتوحة المصدر تجعل تثبيت وتشغيل نماذج الذكاء الاصطناعي المحلية أمرًا بسيطًا وسهلًا حتى للمبتدئين.
المصطلحات التي ستواجهها:
- LLM (Large Language Model): نموذج لغوي كبير يفهم النصوص ويولّدها
- Quantization: تقليص حجم النموذج ليعمل بكفاءة على أجهزة بمواصفات متوسطة
- GGUF: صيغة الملفات الأكثر استخدامًا لتشغيل النماذج محليًا
- RAM: كلما كان لديك ذاكرة عشوائية أكبر، كلما أمكنك تشغيل نماذج أضخم وأذكى
الأدوات والمتطلبات اللازمة
إليك قائمة واضحة بكل ما ستحتاجه:
المتطلبات الأساسية للجهاز:
- ذاكرة RAM لا تقل عن 8 جيجابايت (يُفضَّل 16 جيجابايت للنماذج المتوسطة)
- مساحة تخزين حرة من 4 إلى 20 جيجابايت حسب النموذج
- نظام تشغيل: Windows 10/11، macOS، أو Linux
البرامج المطلوبة:
- Ollama — الأداة الرئيسية لتشغيل النماذج (مجانية تمامًا)
- Open WebUI — واجهة مرئية تشبه ChatGPT تعمل مع Ollama (اختياري لكن موصى به بشدة)
- Docker — مطلوب لتشغيل Open WebUI إذا اخترت هذا الطريق
بدائل مفيدة:
- LM Studio: تطبيق مرئي سهل جدًا للمبتدئين يدعم النماذج بصيغة GGUF
- GPT4All: خيار آخر بواجهة بسيطة ودعم عربي جزئي
- Jan.ai: بديل أنيق يشبه ChatGPT بالكامل ويعمل محليًا
النماذج المقترحة للبداية:
- Llama3: من Meta، ممتاز للمهام العامة
- Mistral 7B: خفيف وسريع وذكي
- Phi-3: من Microsoft، رائع على الأجهزة المتوسطة
- Gemma2: من Google، أداء لا بأس به على الأجهزة المحدودة
متى تحتاج فعلًا إلى تشغيل الذكاء الاصطناعي محليًا؟
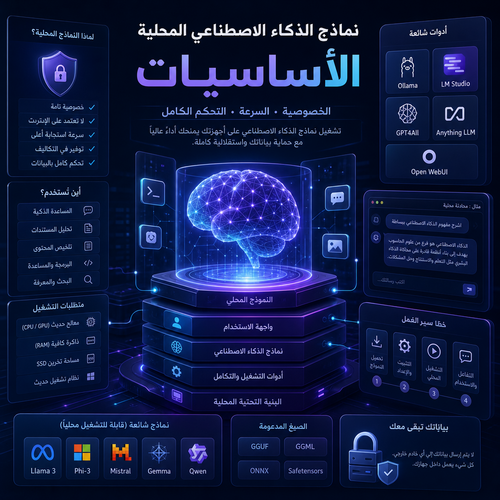
الإجابة الصادقة: ليس الجميع يحتاج إليه، لكن هناك حالات يصبح فيها ضرورة حقيقية.
أنت بحاجة إليه إذا:
- تعمل مع بيانات حساسة: عقود، معلومات طبية، بيانات عملاء
- تعيش في منطقة تفرض قيودًا على الخدمات الخارجية
- تريد تكاملًا داخليًا في مشاريع برمجية دون الاعتماد على API مدفوع
- الإنترنت لديك بطيء أو غير مستقر
- تريد تجربة نماذج AI دون دفع اشتراكات شهرية
حالات الاستخدام العملية:
- كتابة المحتوى وإعادة الصياغة دون مغادرة جهازك
- المساعدة في البرمجة عبر دمج Ollama مع VS Code
- تلخيص المستندات الطويلة بشكل خاص وسري
- بناء روبوتات محادثة مخصصة للمشاريع الداخلية
- التعلم والتجريب دون قيود أو تكاليف
الدليل التطبيقي خطوة بخطوة
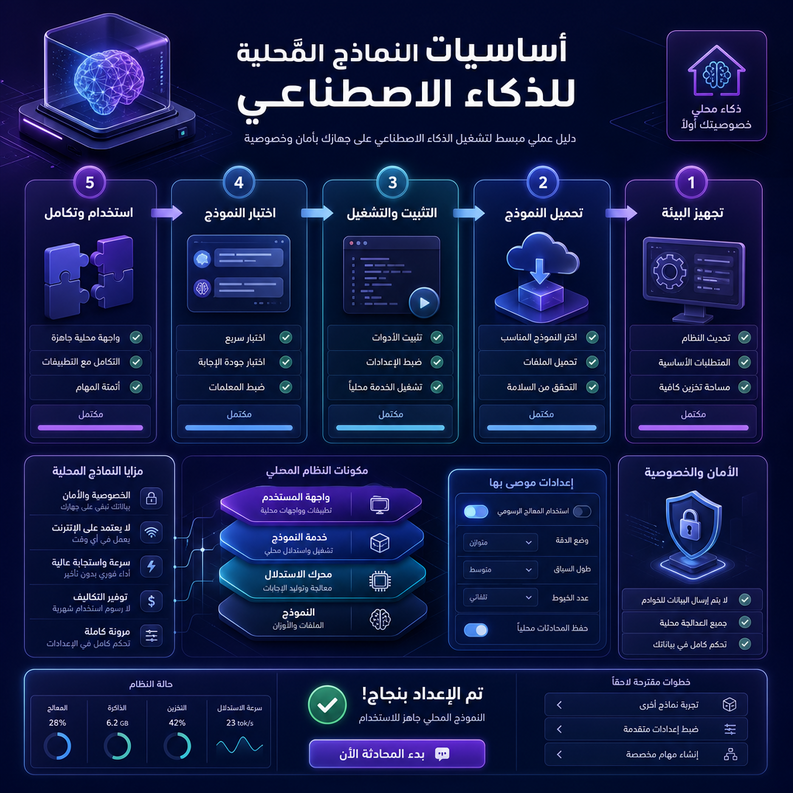
سأريك الطريقة الأسرع والأبسط لتشغيل نماذج AI محلية على جهازك باستخدام Ollama.
الخطوة الأولى: تثبيت Ollama
توجّه إلى الموقع الرسمي [ollama.com](https://ollama.com) وحمّل النسخة المناسبة لنظامك. التثبيت مباشر ولا يستغرق دقيقتين. بعد التثبيت، ستجد Ollama يعمل في الخلفية دون أي تدخل منك.
> تنبيه: على Windows، تأكد من تفعيل دعم الـ WSL2 إذا واجهت أي مشكلة في التثبيت.
الخطوة الثانية: تحميل أول نموذج
افتح الـ Terminal أو Command Prompt واكتب:
“ ollama pull llama3 “
سيبدأ التحميل تلقائيًا. النموذج حوالي 4.7 جيجابايت، لذا أعطه بعض الوقت حسب سرعة اتصالك.
الخطوة الثالثة: تشغيل النموذج والتحدث معه
بعد اكتمال التحميل، اكتب:
“ ollama run llama3 “
وستجد نفسك أمام واجهة نصية تستطيع من خلالها التحدث مع النموذج مباشرة. جرّب اسأله أي سؤال!
> نصيحة: إذا أردت التوقف، اكتب /bye للخروج من المحادثة.
الخطوة الرابعة: إضافة واجهة مرئية (اختياري لكن يستحق)
للحصول على تجربة تشبه ChatGPT تمامًا، ثبّت Open WebUI عبر Docker بهذا الأمر:
“ docker run -d -p 3000:8080 --add-host=host.docker.internal:host-gateway -v open-webui:/app/backend/data --name open-webui --restart always ghcr.io/open-webui/open-webui:main “
ثم افتح متصفحك واذهب إلى localhost:3000 وستجد واجهة أنيقة وكاملة.
الخطوة الخامسة: تجربة نماذج متعددة
الجمال في هذا النهج أنك تستطيع تحميل عدة نماذج واستخدامها حسب الحاجة:
“ ollama pull mistral ollama pull phi3 ollama list “
الأمر الأخير يعرض لك جميع النماذج المثبتة على جهازك.
تذكّر أن Local AI يتطور بسرعة كبيرة، والنماذج الجديدة تصدر بشكل منتظم، لذا تابع التحديثات باستمرار.
فوائد تشغيل الذكاء الاصطناعي على جهازك الشخصي
دعني أكون صريحًا معك في هذا الجزء — هناك فوائد حقيقية وليست مجرد كلام تسويقي.
الخصوصية الكاملة: لا يغادر أي شيء جهازك. محادثاتك، ملفاتك، استفساراتك — كلها تبقى عندك.
صفر تكاليف بعد الإعداد: لا اشتراكات شهرية، لا حدود للاستخدام، لا قيود على عدد الطلبات.
الاستقلالية التامة: إذا انقطع الإنترنت أو أغلقت شركة ما خدمتها، أنت لا تتأثر.
التخصيص العميق: تستطيع ضبط النموذج وتدريبه على بيانات خاصة بك أو بمشروعك.
سرعة الاستجابة: على الأجهزة الجيدة، الاستجابة أسرع من الخدمات السحابية أحيانًا بسبب انعدام زمن الشبكة.
التعلم التقني: فهم كيفية عمل هذه النماذج يفتح لك أبوابًا في عالم الذكاء الاصطناعي والبرمجة.
نصائح إضافية وممارسات احترافية
بعد تجربتي الطويلة مع هذا المجال، هذه أبرز الدروس التي تعلّمتها:
اختر النموذج المناسب للمهمة: لا تستخدم نموذجًا ضخمًا لمهام بسيطة. Phi-3 Mini مثلًا رائع للكتابة اليومية وسريع جدًا.
استخدم Modelfiles للتخصيص: Ollama يدعم ملفات إعداد تسمح لك بتحديد شخصية النموذج وطريقة استجابته من البداية.
دمج Ollama مع أدوات أخرى: يمكنك ربطه مع Continue.dev داخل VS Code للحصول على مساعد برمجة محلي كامل.
راقب استهلاك الموارد: استخدم أوامر المراقبة لتتأكد أن النموذج لا يستنزف ذاكرتك بشكل مفرط.
البديل السهل للمبتدئين: إذا وجدت Ollama معقدًا، جرّب LM Studio أولًا — واجهته المرئية مريحة جدًا وتدعم نفس النماذج.
الأخطاء الشائعة التي يجب تجنّبها
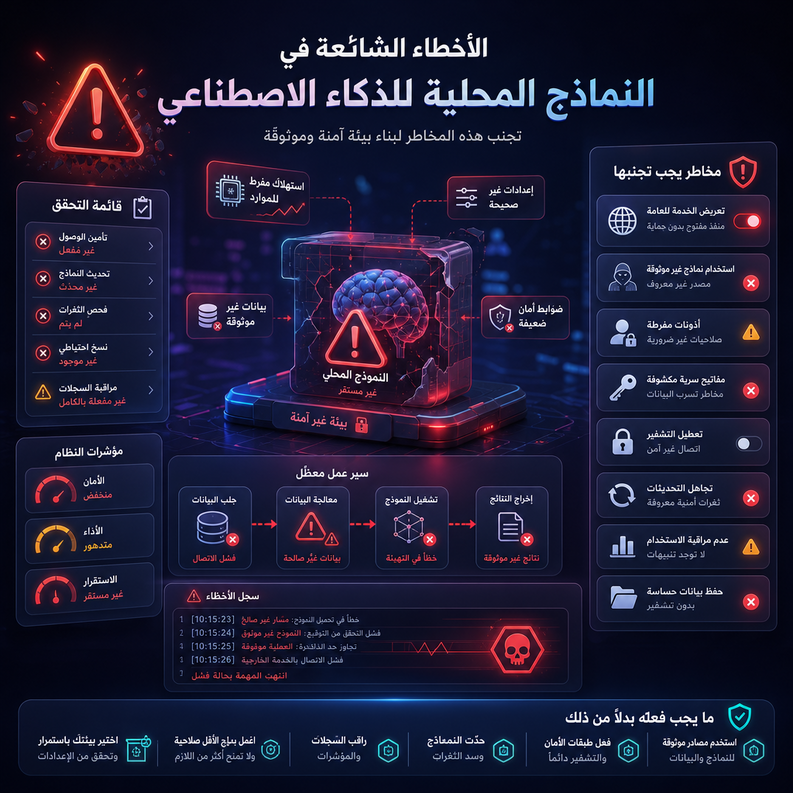
رأيت كثيرين يقعون في نفس الأخطاء عند البداية، هنا أهمها:
خطأ 1: اختيار نموذج أكبر من طاقة الجهاز كثيرون يحاولون تشغيل نماذج 70B على أجهزة بـ 8 جيجابايت RAM والنتيجة تجميد كامل. الحل: ابدأ دائمًا بنماذج 7B أو 8B.
خطأ 2: تجاهل تحديثات Ollama الأداة تتطور بسرعة والتحديثات تجلب أداءً أفضل ودعمًا لنماذج جديدة. راجع التحديثات أسبوعيًا على الأقل.
خطأ 3: نسيان إدارة مساحة التخزين النماذج تأكل مساحة كبيرة. استخدم ollama rm اسم_النموذج لحذف ما لا تحتاجه.
خطأ 4: الاعتقاد بأن النماذج المحلية مثالية النماذج المفتوحة تتطور لكنها لا تزال أقل في بعض المهام المعقدة مقارنة بـ GPT-4. كن واقعيًا في توقعاتك.
خطأ 5: تجاهل إعدادات الأمان لـ Open WebUI إذا شغّلت الواجهة على شبكة مشتركة، تأكد من تفعيل كلمة المرور لتجنب وصول الآخرين لنموذجك.
كيف تطوّر تجربتك مع الوقت؟
الجمال في هذا المجال أنه لا حدود للتطور. إليك خارطة طريق عملية:
المرحلة الأولى (الأسبوع الأول): جرّب نموذجين مختلفين وقارن أداءهما في نفس المهام.
المرحلة الثانية (الشهر الأول): ابدأ بدمج الذكاء الاصطناعي المحلي في عملك اليومي — كتابة، تلخيص، برمجة.
المرحلة الثالثة (ثلاثة أشهر): تعلّم كيفية إنشاء Modelfiles وتخصيص النماذج لمهام محددة.
المرحلة الرابعة (للمتقدمين): ابدأ في استكشاف Fine-tuning — أي تدريب النموذج على بياناتك الخاصة لتحسين أدائه في مجال تخصصك.
تابع مجتمعات مثل Reddit r/LocalLLaMA وقناة Ollama على GitHub لتبقى على اطلاع دائم بأحدث النماذج والتحسينات.
الخلاصة: الوقت المناسب لتجربة هذا هو الآن
إذا وصلت إلى هنا، أنت مستعد فعلًا لتجربة نماذج AI محلية بنفسك. لا يوجد سبب وجيه لتأجيل هذه التجربة — الأدوات مجانية، التثبيت أصبح بسيطًا، والفوائد حقيقية وملموسة.
أنا شخصيًا أستخدم هذا الإعداد يوميًا في عملي، وأنصحك بشدة أن تبدأ بالخطوات الأساسية التي شرحتها. مع Local AI كمنهجية عمل، أصبحت أقل اعتمادًا على الخدمات الخارجية وأكثر تحكمًا في أدواتي الرقمية.
جرّب، تعلّم من الأخطاء، وشاركنا تجربتك في التعليقات — أنا دائمًا هنا للإجابة على أسئلتك.
الأسئلة الشائعة
هل أحتاج إلى كرت شاشة قوي لتشغيل النماذج المحلية؟ لا، يمكنك البدء بالمعالج الرئيسي CPU فقط. الـ GPU يسرّع الأمور كثيرًا لكنه ليس شرطًا للبداية. حتى أجهزة MacBook بشريحة M1 تعمل بشكل ممتاز مع Ollama.
هل النماذج المحلية تفهم اللغة العربية؟ بعضها نعم وبعضها ضعيف في العربية. Llama3 وMistral لديهما فهم معقول للعربية، لكن أداؤهما بالإنجليزية أفضل. هذا الجانب يتحسن بسرعة مع الإصدارات الجديدة.
كم يستغرق تحميل النموذج لأول مرة؟ يعتمد على سرعة اتصالك وحجم النموذج. نموذج 7B بحجم 4-5 جيجابايت قد يستغرق من 10 إلى 30 دقيقة. بعد التحميل الأول، التشغيل فوري تمامًا.
هل يمكنني استخدام أكثر من نموذج في نفس الوقت؟ من الناحية التقنية نعم، لكن غير موصى به إلا إذا كان لديك RAM كافية. تشغيل نموذجين في آن واحد يتطلب ضعف الموارد.
هل هذا الإعداد مناسب للشركات والمؤسسات؟ بالتأكيد، وهذا في الواقع أحد أقوى حالات الاستخدام. الشركات التي تتعامل مع بيانات حساسة تستفيد كثيرًا من نشر نماذج AI على خوادمها الداخلية دون أي تواصل مع الخارج.